ChatGPT 模型 GPT-6 Sol、Luna、Astra 差在哪?功能、費用與適用情境完整比較!
OpenAI 最近發布 GPT-6 Sol 跟 GPT-6 Luna 了,而我自己現在是 Pro20X 的用戶,當然也就立刻開始使用這兩個模式。我自己用過 GPT-6 Luna 之後,覺得這模型雖然便宜,但是模型能力達不到我的要求,而 GPT-6 Sol 算是能夠免強勝任工作,但也沒有到非常驚艷的地步,甚至會有種 GPT-5.6 Sol 有時可能表現更好的感覺。
GPT-6 Astra 自從推出之後,讓人最大的感受就是:雖然模型很強,但是太貴。我自己本身是 Pro20X ,也差不多三天就耗盡每週用量,剩下來的四天基本上什麼事都不能做。實際測試過 GPT-6 Sol(xhigh)之後,GPT-6 Sol 的能力還行,且使用量大幅降低,可以一週七天不斷地跑任務工作,算是彌補 GPT-6 Astra 太過昂貴的不足。
這篇文章會從目前 GPT-6 這三個模型的:用途、規格、跑分、費用與實際工作情境 來進行比較。讓你知道自己應該如何從這三款模型最選擇。
GPT-6 Luna、Sol、Astra 怎麼選?
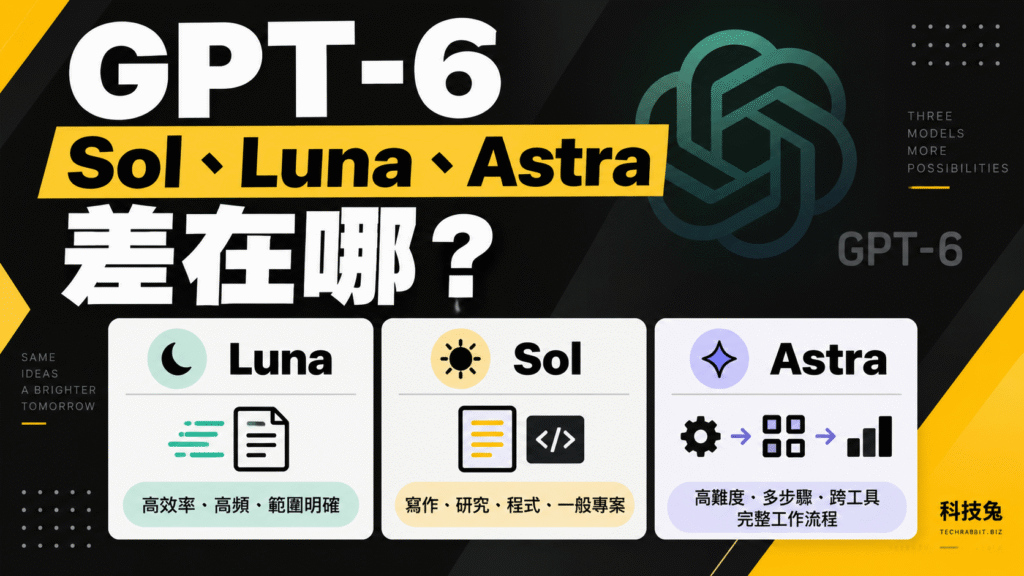
下面簡單的列出 GPT-6 Luna、GPT-6 Sol、GPT-6 Astra 這三款模型的定位。
| 模型 | 官方定位 | 適合先拿來做什麼 |
|---|---|---|
| GPT-6 Luna | 範圍明確、高頻工作所需的高效率模型 | 摘要、擷取欄位、分類、固定格式整理 |
| GPT-6 Sol | 寫作、程式與需要判斷的日常主力模型 | 寫文章初稿、研究整理、一般專案與程式工作 |
| GPT-6 Astra | OpenAI 能力最高、用於高難度完整任務的模型 | 複雜分析、跨工具操作、要求較高的文件或專案成果 |
表格右欄是OpenAI 模型選擇指南的使用建議。差別在於你需要多少判斷、任務做得多頻繁,以及願意用多少額度。
如果你不知道從哪款開始,可以先問自己:工作規格清楚、需要大量重複嗎?如果是,那就先試 Luna。需要閱讀資料、取捨內容並寫成完整成果嗎?如果是,那就先試 Sol。任務跨很多步驟,還要操作工具並反覆核對成果嗎?如果是,那再考慮 Astra。
GPT-6 三款模型規格有什麼差別?
| 比較項目 | GPT-6 Luna | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
| 官方定位 | 高效率、高頻且範圍明確的任務 | 複雜程式與代理工作流程;兼顧能力與成本 | 最困難的完整工作流程 |
| API 模型名稱 | gpt-6-luna | gpt-6-sol | gpt-6-astra |
| API 上下文視窗 | 105 萬 Token | 105 萬 Token | 105 萬 Token |
| API 最多輸出 | 12.8 萬 Token | 12.8 萬 Token | 12.8 萬 Token |
| 知識截止時間 | 2026 年 5 月 18 日 | 2026 年 4 月 20 日 | 2026 年 4 月 30 日 |
| API 推理強度 | none、low 至 max | none、low 至 max | low 至 max |
規格依據:OpenAI GPT-6 Luna、GPT-6 Sol、GPT-6 Astra。上表是 API 模型規格;ChatGPT 或 Codex 介面實際可用的容量、推理選項,仍要以產品與帳號設定為準。
這裡最容易誤會的是上下文視窗。三款模型的官方 API 標示都一樣,並不是 Astra 才能處理長文件。
GPT-6 Luna:適合規格清楚、常常要重複的工作
如果你有一百篇文章,要從每篇抓出標題、日期和網址,再整理成表格,Luna 就很適用於這種情況。工作要先做什麼、輸出長什麼樣子都已經說清楚,重點是穩定地把每筆資料處理完。
OpenAI 將 Luna 定位為處理範圍明確、高頻任務的高效率模型,舉例包括摘要、資料擷取與聚焦的程式工作。資料來源:OpenAI 模型說明
Luna 也不是只能做簡單的工作。OpenAI 公布的程式任務評測顯示,調高推理強度後,它也能處理較難的工作。資料參考:Introducing GPT‑6 Sol and Luna
GPT-6 Sol:寫作、研究與一般專案的主力選擇
Sol 適合「事情不是只有照格式搬運,還需要判斷怎麼做」的工作。例如,給它一份研究資料和幾個官方來源,請它核對事實、整理出讀者最在意的問題,再寫成一篇初稿。
OpenAI 將 Sol 用於複雜程式與代理工作流程,也把它列為寫作、程式與需要判斷的日常工作選擇。資料來源:OpenAI API 模型頁、模型選擇指南
如果你平常用 Codex 整理網站檔案、修改程式,或用 ChatGPT Work 寫文件、做研究,Sol 可以作為第一個嘗試的模型。
GPT-6 Astra:適合難度高、步驟多的完整任務
假設你要它讀完多份來源、操作網站或軟體、整理資料、產出文件,最後再檢查內容有沒有漏掉。這種工作不只是回答一個問題,而是要把好幾個環節串起來,Astra 的定位就比較符合。
OpenAI 將 Astra 稱為目前能力最高的模型,特別提到複雜推理、程式、電腦操作、研究和文件製作。資料來源:OpenAI GPT-6 Astra 模型頁
OpenAI 公布了哪些 GPT-6 跑分?
官方跑分要連同測試的工作類型,以及模型使用的推理強度一起看。GPT-6 Astra 與Sol、Luna 各自公布了不同設定下的結果:
| 評測 | 測什麼 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|---|
| AutomationBench | 跨應用程式的商務工作流程 | 41.4%(官方公布的最高分);low 設定為 30.3% | xhigh 33.2%;每項任務估算 API 成本 US$0.27 | high 比 GPT-5.6 Luna 高 5.4 個百分點、每項任務成本低 58%;未在這兩篇文章公布可直接比較的絕對分數 |
| Agents’ Last Exam | 需要較長時間完成的複雜專業工作 | 59.3% | max 56.4% | 未公布可直接比較的分數 |
| DeepSWE v1.1 | 真實程式庫中的複雜軟體工程任務 | 74.1% | max 68.8% | max 66.6% |
| OSWorld 2.0 offline | 長流程的電腦操作 | 72.6% | xhigh 60.5% | max 勝過 GPT-5.6 Sol(medium),每項任務成本約為後者的十分之一;未公布可直接比較的絕對分數 |
Astra 欄位取自其發布頁的各推理強度最高結果;Sol、Luna 欄位是另一篇發布文章明示的 xhigh、max 或 high 設定,不是三款模型在相同推理強度下的對照實驗。例如 AutomationBench 中 Sol(xhigh)的 33.2% 高於 Astra(low)的 30.3%,但 Astra 在較高設定下的官方最高分是 41.4%。
OpenAI 另外表示,Sol 在檢查程式修改能否合併進專案的 FrontierCode 上,較 GPT-5.6 Sol 有明顯進步。它的事實性內部評測錯誤約為前代一半;Luna 在較高推理強度下也有所改善。但這項事實性測試挑的是曾被使用者標記出錯的對話,不能當成一般聊天的錯誤率。資料參考:OpenAI GPT-6 Sol 與 Luna
第三方測試怎麼看?
獨立評測網站 Artificial Analysis 使用同一版本的 Intelligence Index v4.3.2 測試三款模型。以下都採 max 推理強度,方便比較同一套測試下的結果:
| 模型 | 綜合指數分數 | 每項指數測試任務的平均成本 |
|---|---|---|
GPT-6 Luna(max) | 37 | 約 US$0.07 |
GPT-6 Sol(max) | 48 | 約 US$1.06 |
GPT-6 Astra(max) | 53 | 約 US$3.26 |
這個「分數」是該網站彙整多種測試後的指數,不是答對率百分比;「每項任務成本」也只適用於它的測試組合,不能直接換算你在 ChatGPT 或 Codex 做一件事要花多少錢。它提醒我們:Astra 在這套測試中拿到最高分,Sol 接近但測試成本較低;Luna 的分數較低,測試成本也最低。測試結果會隨版本、模型設定和服務狀態更新。Artificial Analysis 的 Sol 頁面目前標示約 87.2 萬 Token 上下文,與 OpenAI 官方的 105 萬 Token 規格不同;本文的 API 規格以官方文件為準。資料來源:Artificial Analysis Astra、Sol、Luna、OpenAI Sol 模型規格]
不同評測的百分比也不能互相比大小。 AutomationBench 的 33.2% 和 DeepSWE 的 68.8% 測的是不同任務;官方研究環境或 API 的結果,也可能與正式版 ChatGPT 略有不同。對一般使用者來說,最後還是拿自己常做的工作,用同一份輸入比較成果、完成時間與用量最有參考價值。資料來源:OpenAI 模型選擇指南
三款模型的費用差多少?先分清楚兩種計價
1. 使用 OpenAI API:依 Token 計價
以下是標準情況下的文字 API 定價,單位為美元/每 100 萬 Token。「快取輸入」指符合快取條件、被重複使用的輸入內容。
| 模型 | 一般輸入 | 快取輸入讀取 | 輸出 |
|---|---|---|---|
| GPT-6 Luna | US$0.10 | US$0.01 | US$0.50 |
| GPT-6 Sol | US$2.00 | US$0.20 | US$10.00 |
| GPT-6 Astra | US$10.00 | US$1.00 | US$50.00 |
依OpenAI API 價格頁,同樣是標準情況下的短上下文費率,Sol 的每 Token 價格是 Luna 的 20 倍,Astra 是 Sol 的 5 倍。但單次任務花多少,還要看實際輸入輸出 Token、快取、工具呼叫與處理模式。三款模型的輸入如果超過 27.2 萬 Token,官方會對整筆請求套用長上下文價格:輸入與快取費率變為 2 倍,輸出費率變為 1.5 倍,不只是超出的部分加價。資料來源參考:OpenAI GPT-6 Sol 模型定價說明、Astra 模型定價說明
如果你用過前一代模型,GPT-5.6 Sol 輸入/輸出價格由每百萬 Token US$4/20 降到 GPT-6 Sol 的 US$2/10;GPT-5.6 Luna 則由 US$0.20/1.20 變成 GPT-6 Luna 的 US$0.10/0.50。這些是與前代API 價格相比,並不是 ChatGPT 訂閱月費變便宜。
舉個純文字計算例子:如果一次請求用了 1 萬個一般輸入 Token、2,000 個計費輸出 Token,沒有快取或額外工具費,按上述費率估算,Luna 約 US$0.002、Sol 約 US$0.04、Astra 約 US$0.20。這 2,000 個輸出 Token 必須包含模型產生的不可見推理 Token,不能只數畫面上看到的回答文字。實際任務不一定會用掉一樣多的 Token;推理強度調高,也可能增加使用量。資料來源:來源:OpenAI 推理模型說明
2. 使用 ChatGPT Work 或 Codex:看方案額度與 Credits
如果你是用 ChatGPT 帳號登入 Work 或 Codex,不能把上面的 API 美元計價直接當成每則訊息的收費。OpenAI 的ChatGPT 價格頁另有方案用量與 Credits 說明;每則訊息消耗多少,會受任務長度、推理、工具和快取影響。
官方列出的文字 Token Credit 費率如下,單位為每 100 萬 Token:
| 模型 | 輸入 Credits | 輸出 Credits |
|---|---|---|
| GPT-6 Luna | 2.5 | 12.5 |
| GPT-6 Sol | 50 | 250 |
| GPT-6 Astra | 250 | 1,250 |
這些數字適合拿來理解模型的相對用量,不是說你打一則訊息就會扣掉表格中的全部 Credits。以 Plus 方案為例,OpenAI 提供的每五小時本機訊息數估算如下:
| 模型 | Plus 方案每五小時本機訊息數估算 |
|---|---|
| GPT-6 Luna | 350~3,000 則 |
| GPT-6 Sol | 15~150 則 |
| GPT-6 Astra | 5~45 則 |
這些是估算範圍,實際使用量會受任務長度、工具操作和推理設定影響,也可能有每週限制;要確認自己的剩餘額度,請看帳號中的用量畫面。
實際工作該選哪個?三個例子
情境一:整理大量文章資料
要從大量文章擷取標題、日期、分類,並輸出固定欄位表格,可以先用 Luna。抽幾筆檢查正確率;如果資料混亂到每篇都需要重新判斷,再換 Sol。
情境二:根據資料寫一篇教學文章
需要讀官方說明、挑出讀者會問的問題、安排段落並撰寫初稿,可以先用 Sol。要求它附來源,並把查得到的事實和自己的建議分開。如果還要跨多份文件、網頁與檔案反覆處理,才考慮 Astra。
情境三:完成一個跨工具專案
要讀檔案、操作應用程式、修改內容、輸出成品,再核對每一項需求,可以考慮 Astra。任務越長,越要先講清楚成果、資料來源與不能改動的範圍;模型能力高,仍需要你驗收成果。
模型選擇也不是一次決定後永遠不變。OpenAI 建議拿同一種實際任務比較結果、完成時間與用量,再選能達到品質要求、同時比較省資源的設定。
總結
當我們在選擇模型的時候,大致上就是:Luna 適合清楚、重複的任務;Sol 適合需要判斷的日常工作;Astra 適合高難度、跨多個步驟的完整成果。三款模型的官方 API 上下文容量則基本相同。
目前我自己個人日常都是使用 GPT-6 SOL,但是偶爾需要處理複雜任務或設計的時候,才會切換到 GPT-6 ASTRA,這樣可以節省不少用量,提供給大家參考。
